приветствую, господа вайбкодеры. Если вы давно хотели вкатиться в тему с иишечкой, но стеснялись спросить, как это сделать, то вам невероятно повезло, потому что у вас есть я. Конечно, про то, как настроить иишечку, можно спросить у иишечки (внезапно), но для этого надо знать, что именно спрашивать, а это знают не только лишь все. Так что let me be proactive and helpful и погнали.
Рассматривать мы будем, понятное дело, настройку нашей собственной локальной иишечки для бытовых нужд. Она конечно не такая мощная и резкая как чатгпт, зато своя родная, никуда не убежит и не сдаст твои данные куда не следует. Я це люблю.
 Итак, что нам понадобится?
Видеокарта
с большим количеством видеопамяти. Для примера возьмём мою древнюю 3090ti с 24 гигами.
Оператива. Чем больше тем лучше. Недостаток видеопамяти компенсируется за её счёт. Она медленнее чем видеопамять, но хоть что то.
Серверная часть, на которой работают модели. Самая ходовая народная приблуда это
Ollama, ставится бесплатно без смс и требует минимум мозга.
Собственно
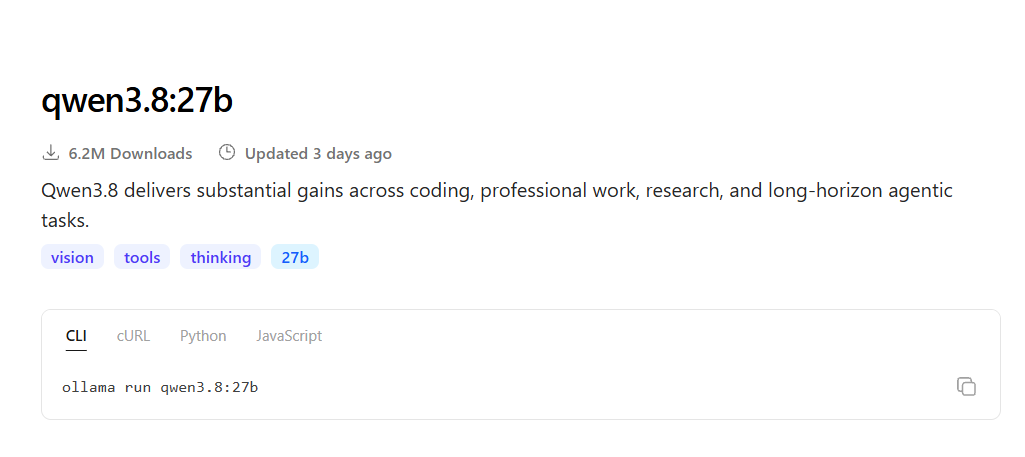
модель. Самая ходовая народная приблуда это
Qwen3.8:27b, видеокарты с 24 гигами как раз хватает чтобы держать её в диапазоне 64-128к токенов, что для кодинга вполне сносно.
Интерфейс для работы с моделью. Мне больше всего нравится плагин Cline для VScode, удобный и содержит хорошие тулзы для модели. Ну и бесплатный о5 же.
Аппаратная часть.
Модель в активном режиме сожрёт все ресурсы твоей видеокарты и оперативы, так что играть в игрульки и смотреть кинчики ты не сможешь. Что довольно уныло. Потому если есть финансовая возможность, лучше взять отдельный системник и сделать из него чисто сервак с иишечками. Если же такой возможности нет, тебе поможет встроенная видеокарта. Лучше переткнуть монитор в неё а также повесить на неё отрисовку всех твоих прожек (браузера там, виндоуз эксплорера, самой vs студии), а основную оставить девственно чистой. Если же и встроенной видеокарты нет, то помянем. придётся тебе не запускать на компе вообще ничего, имеющего хоть какую то визуальную составляющую, а саму студию сворачивать в трей во время работы модели. Но я уверен, что ты умный и найдёшь выход из положения.
Если же ты выбрал вариант с серваком, позаботься о надёжном коннекте с ним по проводу, иначе если вайфай мигнёт, сессия прервётся и придётся начинать с начала.
Программная часть.
Если ты определился где должны жить модели, начинаем устанавливать.
1. Заходим на
https://ollama.com/download и скачиваем саму олламу. никаких настроек нет, она сама ставится куда то на диск це, но вот модели весят много гигов, поэтому лучше зайди в настройки (через иконку в таскбаре) и выбери место для них где нибудь на жирном диске.
2. Заходим на сайте олламы в
models и выбираем модель. там же будет подсказка что прописать чтобы скачать её. пока ты не шаришь, просто ставь квен, прописав в cmd команду "
ollama run qwen3.8:27b", оно само скачается и запустится.
3. Ставим
VScode и плагин
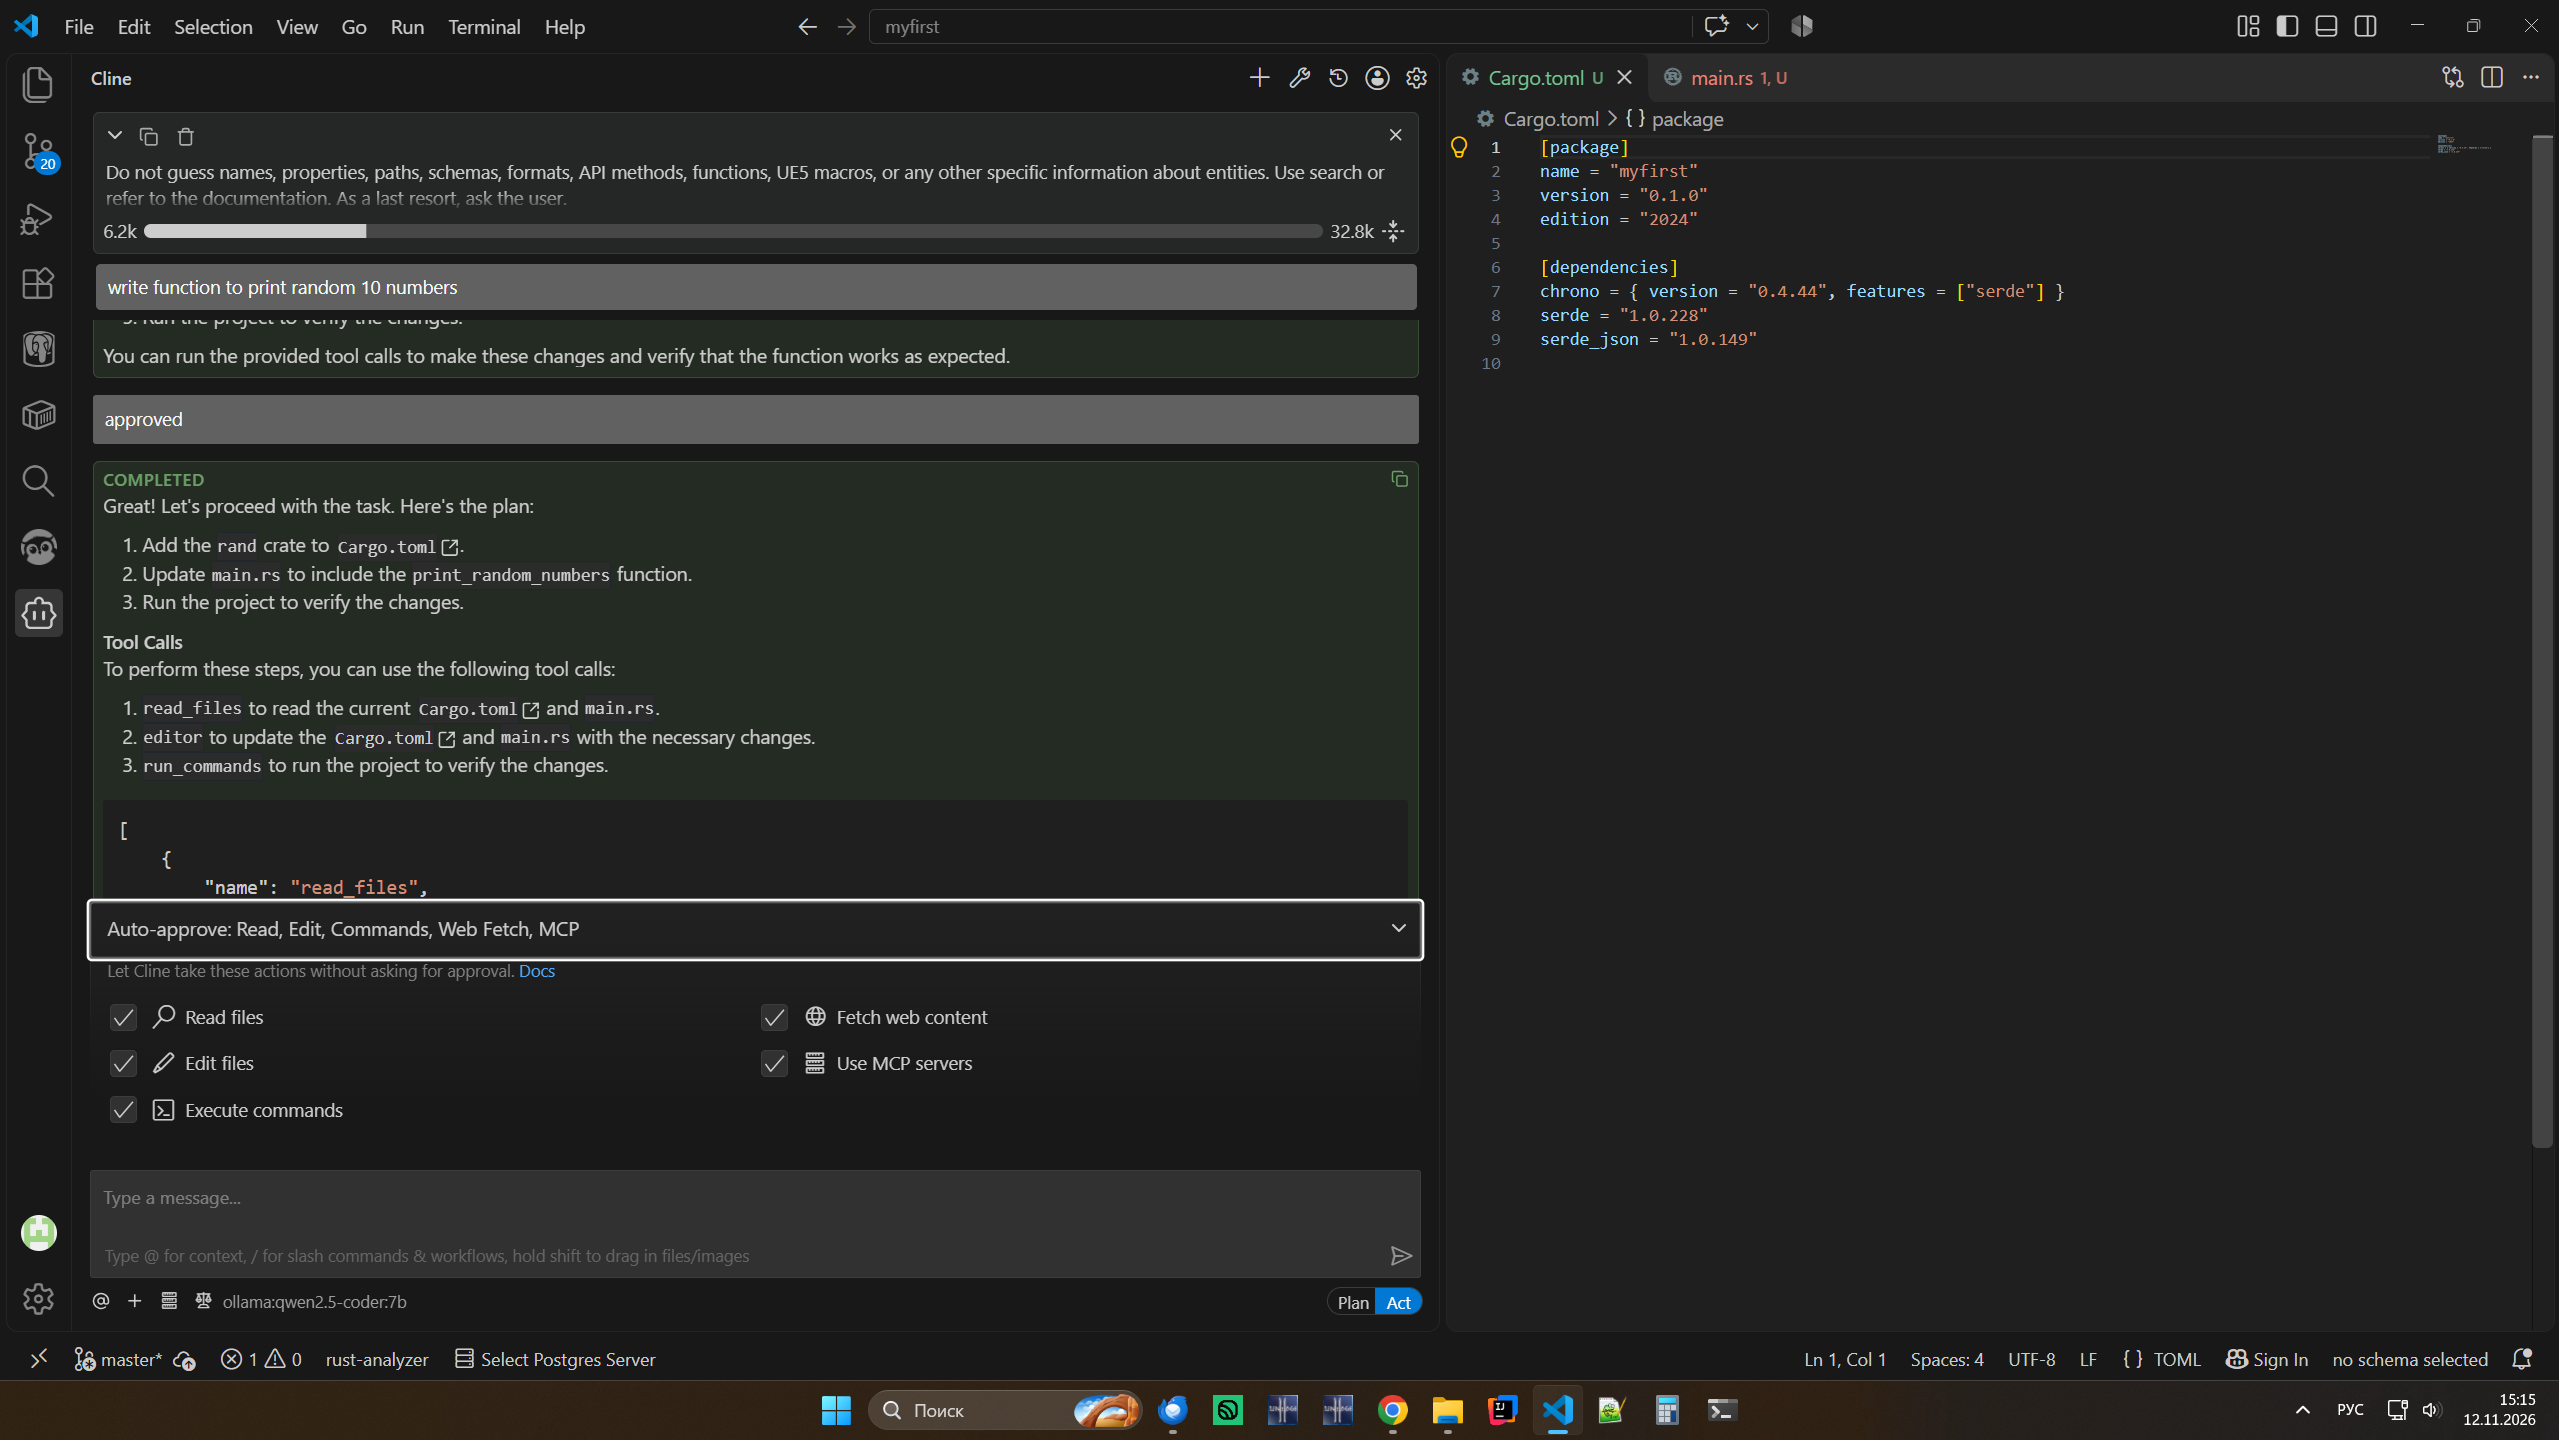
Cline, в принципе там всё легко, не буду тут расписывать шаги как для дауна, ты же не такой, верно? Что продемонстрирую так это конфиг Cline для твоей олламы.
4. Так же не забудь обновить системный
powershell до последней версии. Бот выполняет много действий через powershell, и если он устаревший, то будет много ошибок из за синтаксиса и форматирования команд.
Не лишним будет прописать переменную среды OLLAMA_KEEP_ALIVE=1h, иначе она будет выкидывать модель из памяти через 5 минут простоя и ты задолбаешься её заново прогружать на каждом запросе.

В принципе, с этого момента уже можно начинать пользоваться данной конструкцией. Но поскольку у нас бомже конфиг, и нет никаких кастомных настроек, ботяра скорее всего будет тупым, тормозным, и заниматься какой то хyйнёй вместо реализации твоих гениальных идей. Потому, чтобы стать истинным мастером нейрослопа, нужно расширить своё понимание происходящего. Этим и займёмся.
В чём суть нейросети?
Вопреки расхожему мнению, "искусственный интеллект" это не какой то мозг в банке, который делится вселенской мудростью. Фактически, это вообще не какая то отдельная сущность, это процесс, который происходит, когда через таблицу чисел (весов) размером в гигабайты (именно она занимает место на диске и твою видеопамять) прогоняется массив токенов в виде текста, картинок и чего ты ещё туда засунешь. Это всё. Больше никакой магии тут нет. Данный массив токенов называется "контекст", и от его размера, и от размера таблицы весов, зависит скорость происходящего. Особенно на бомже конфигах.
27b в названии модели qwen3.8:27b означает 27 миллиардов нейронов, то есть элементов таблицы весов. и через все эти 27 миллиардов прогоняется каждый токен контекста, который вмещает в себя примерно 4 английских символа, или 2 русских, потому как русские символы в кодировке весят в 2 раза больше, чем английские. Экая несправедливость. Бат фак ит.
Поскольку уменьшать размер модели не выгодно, наоборот, чем она больше, тем умнее, дабы уложиться в рамки наших технических возможностей мы должны будем оптимизировать контекст, дабы не тратить время и ресурсы на балласт, и получить максимальную эффективность от каждого запроса.
В чём суть процесса?
Каждое сообщение боту и ответ на него называется "ход" (turn), ага, как в шахматах. Дабы он "помнил", о чём был предыдущий разговор, ему надо послать не только твой текущий запрос, но и содержание всех предыдущих ходов. Для этого и нужен контекст. Каждый раз, когда ты пишешь запрос боту, вместе с ним отправляется и всё, что было написано до этого, потому в "многоходовочках" контекст постепенно раздувается до совершенно невменяемых размеров. И чтобы поддерживать быстродействие бота на должном уровне, его во первых искусственно ограничивают, во вторых добавляют механизм сжатия (compaction), который удаляет более старое содержимое контекста, заменяя его кратким содержанием ("мы разрабатывали чё то там на петоне"). Потому в долгих сессиях неизбежна потеря некоторого количества данных, от чего бот начинает тупить и "забывать", о чём была речь пару страниц назад, что наверняка раздражало тебя в разговорах с чатжипитишкой. В кодинге же это может вылиться в то, что бот запутается в архитектуре проекта, сойдёт с ума и начнёт городить чёрт знает что. Но мы попробуем победить данный эффект. Для начала разберём структуру хода.
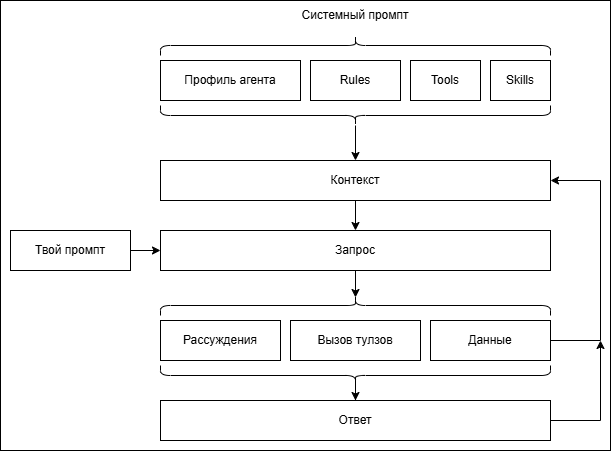
Итак, каждый ход мы отправляем в бота:
- Системный промпт, который содержит основные указания о том, что должен и не должен делать бот. В чатжипитях он скрыт от посторонних глаз, но в твоём случае он является важной частью работчего процесса. Его структура и способ заполнения зависит от конкретного интерфейса. Но общий принцип везде одинаковый. Важным свойством системного промпта является то, что он не попадает под compaction, а следовательно всегда висит в контексте в исходном виде, и представляет собой обязательный "налог" в виде некоторого количества токенов, из за чего желательно, чтобы он был максимально компактным и функциональным. Зато его содержимое никогда не удаляется и не искажается, что полезно, если надо чтобы бот ни в коем случае не потерял некую важную информацию.
-- Профиль агента. Содержит основные правила. Вроде "Твоя работа развлекать посетителей нашего чатика, общайся как портовая шлюха и докапывайся до всех подряд", "По подозрительным ссылкам не переходи", итп.
-- В Cline также можно создавать дополнительные
разделы правил (rules), которые можно включать и выключать, в зависимости от текущей задачи, чтобы не грузить контекст балластом. Можно создать разные правила написания на C++ и петоне, например, и включать то одно то другое. Удобно.
-- Tools (инструменты) описывают то, что должен делать бот, чтобы добиться определённого результата. Фактически представляют собой набор мини-промптов и скриптов, например инструмент write_file запускает скрипт который запускает команду CreateFile в powershell и передаёт в неё содержимое в каком то там виде. Утрирую, конечно. На практике они чуть более продуманы, дабы учесть возможные фейлы, например не дать боту сгрузить в контекст несколько мегабайт содержимого, от чего твоя видеокарта встанет колом. Тулзы являются частью интерфейса, так что поменять их ты их просто так не сможешь. При желании, если ты крутой прогер, то можешь и поковыряться в исходниках опенсорсного Cline, можно, а зачем, если у нас есть skills.
-- Skills фактически представляют собой кастомные tools, которые ты можешь написать сам. Их отличие от tools в том, что они не висят постоянно в системном промпте, а подгружаются по требованию, и удаляются при компактинге, так что это легковесная необязательная версия тулзов, для тех случаев, когда некоторые действия требуются ситуативно, или требуют слишком сложного описания, чтобы держать их в контексте постоянно.
 Итак, что мы можем покрутить в нашем системном промпте, дабы избавить бота от лишней суеты, сделать его экономным и при этом функциональным?
Бот это прямо как младший сотрудник айтишечки, исполнительный, но тупой. Он будет изо всех сил стараться угодить хозяину, но если ты ему не дал конкретных указаний, или дал, но не конкретные и противоречивые, он будет рвать жопу и пытаться обьять необьятное, как буриданов осёл, перед которым поставили не две, а сразу штук 10 кормушек. В результате процесс превратится в бесконечный перебор каких то файлов, ссылок, сетевых запросов и написание дебильного кода. Так что в первую очередь нам надо ограничить его неуёмную прыть и заставить думать о деле.
- Первое, что обязательно нужно сделать, это
запретить ему фантазировать. Вся фантастика мира представляла нам ИИ как нечто фундаментально не умеющее врать, но на практике первое, чему он научился, это высасывать из жопы инфу, которой у него нет (хе хе). А нам это не надо, потому это надо явно запретить строкой вида "Do not guess names, properties, paths, schemas, formats, API methods, functions, UE5 macros, or any other specific information about entities. Use search or refer to the documentation. As a last resort, ask the user." (мы же помним что русский язык в 2 раза тяжелее английского по токенам, так что все портянки пишем на английском. Это не идеологическое решение, а сугубо техническое, так что Имперская канцелярия может спать спокойно. Если ты в нём не шаришь, можешь написать свои конфиги на русском и приказать перевести этому же самому боту.)
- Второе что мы должны сделать, это
предоставить ему конкретику. Мы же приказали ему искать, а не угадывать, но не сказали где, так что ему придётся угадывать где искать. Потому если у тебя есть инфа, которая поможет боту выполнить задачу, пропиши её явно. Мой проект лежит там, репозиторий там, настройки в этом файле, документация по такой то ссылке. Это здорово сэкономит боту количество телодвижений а следовательно времени и токенов. Если же инфы у тебя нет, можно выяснить её с помощью этого же бота в отдельной сессии, а результат сохранить в системном промпте для последующих.
- Избегай косметики и витиеватого поэтического слога, для бота это балласт. Не надо писать "если тебе надо зайти на сайт то ты должен открыть powershell и выполнить команду...". Пиши проще "Web access: powershell - Invoke-WebRequest", этого ему вполне хватит чтобы разобраться. Для более сложных запросов желательно предоставить образец синтаксиса.
- Если нужно какое то супер сложное описание некоторого процесса с примерами итп, есть смысл
вынести это в отдельный файл или skill, а в правилах создать только ссылку на него "to import 3d model from blender to ue5 - see ImportInstructions.md". Он затянет этот файл в контекст, когда ему будет надо, потом компактинг сольёт его в помойку, а системный промпт останется лёгким.
- После того как ты теоретически проработал архитектуру своего проекта, есть смысл
создать отдельное правило и захерачить её туда, перед тем как создавать сессию для реализации. Так она не скомпактится и будет постоянно висеть у бота перед носом, не давая ему уехать не в ту степь.
- Также
неплохими настройками будет "First accumulate all needed recon per turn, then check with minimal necessary tool calls." и "First accumulate all necessary file modifications per turn, then write all to files at once.", дабы он не пытался спамить вызовы тулов, а сперва продумал все правки и все возможные направления поиска, а потом отработал всё в одну-две команды. Так оно будет намного эффективнее. Также не помешает что то типа "Avoid "just in case" checks, do only relevant for task completion." дабы он не лез проверять какие то богом забытые логи, потому что ему что то показалось. Здесь же ты можешь настроить стиль написания кода под себя, защиту своего компа от случайного изменения конфигов винды скриптами, итд, итп. По ходу дела разберёшься что ещё дописать. Ну ты понел короче - англицкий язык, минимум словесного балласта, максимум конкретики, сокращение ненужных телодвижений, декомпозиция сложных правил по скиллам и файлам. Можешь так же приказать боту
проверить системный промпт на предмет маразмов и противоречий, очень полезный фидбек.
 Рабочий процесс хода у нас представляет собой следующее:
Рассуждения.
Чем их больше, тем лучше бот прорабатывает детали задачи. Но вместе с тем и сильнее грузит контекст. А если он таки зафейлился и поехал не в ту степь, рассуждения превращаются в чистой воды балласт и источник неправды, вплоть до того, что проще дропнуть сессию и рестартануть, тк пока он сам догадается, что обосрался, может пройти крайне много времени. Если это случилось, обязательно разберись почему, и внеси соответствующие изменения в правила, чтобы больше такого не происходило. Можно конечно и понизить уровень рассуждений, но тогда и результат будет так себе, алсо не все модели позволяют его менять.
Вызовы тулзов и их результаты. Все запущенные скрипты, веб запросы и команды повершела тоже попадают сюда, впрочем как и ответы на них. А количество вызовов тулзов сильно зависит от того, что ты прописал в правилах. Если ты вместо конкретных указаний заставишь бота гадать и действовать перебором, то ему придётся вызвать очень много тулзов, чтобы наконец попасть в нужное место. Результаты вызова тулзов тоже могут быть самыми разными, например логи длинной в миллион строк, которые запустят твоего бота в космос вместе с видеокартой. Тулзы конечно хендлят подобные случаи, жёстко ограничивая вывод например 6000 строк, но что делать если то что тебе нужно находится на 6001й строке? Такие случаи придётся хендлить уже тебе, йуный падаван.
Итак, что мы можем покрутить в нашей сессии, дабы избавить бота от лишней суеты, сделать его экономным и при этом функциональным?
- Пиши нормальный запрос, в котором ты точно знаешь, что тебе нужно от несчастного бота. Если ты неточно это знаешь, сперва выясни это во второстепенных сессиях, а основную уже создавай с полным пониманием. Это должно быть не говно типа "сделай мне чтобе там че то свистело пердело", а готовая архитектура, продуманная на бумаге до мелочей, где какая кнопка находится, какой запрос шлёт, что должно прийти в ответ, и что делать если в ответ пришло говно, итд итп. Чтобы боту осталось только код написать. В идеале всё должно быть сделано за один ход, а все спорные моменты разруливаться либо системным промптом, либо грамотно составленным запросом. Если пришлось тратить ходы на уточнения, разъяснения и переделывания, то это твой фейл и может привести к крайне херовому конечному результату. Так что учись играть в шахматы и ставить мат в три хода, а лучше в один.
- Не пытайся объять необъятное слабеньким мозгом бота, сиречь если проект большой, не пытайся скормить ему сразу всю архитектуру, иначе он порвётся как грелка. Делай по одному модулю за раз. Сперва интерфейс. Потом отправка запроса. Потом разбор ответа. Потом обработка данных. Потом отрисовка результата. Тестируй то что уже сделано прежде чем двинуться дальше. Комитить не забывай на случай если бот запорет что то. Тише едешь дальше уедешь.
- если нужно сменить тему или углубиться в теорию, создай новую сессию, иначе весь предыдущий контекст превратится в балласт, и вызовет у бота искреннее недоумение, он будет до усрачки пытаться понять, как связан C++ и размножение гиббонов на Борнео. Может и какое интересное научное открытие сделает.
- Обрабатывай жирные файлы и результаты запросов. Если ты знаешь что в этом месте должна прийти портянка на лям строк, явно пропиши "не затягивать логи в контекст а использовать GREP по коду ошибки", "не перечитывать файл заново если редактирование прошло успешно". "записывать результат запроса сразу в файл без вывода", итд итп. для этого надо понимать конечно что у тебя откуда и зачем берётся.
- позаботься о troubleshooting. если у тебя отвалился коннект к серваку, бот будет либо пытаться тупо переконнектиться, отправляя кучу запросов, либо начать городить костыли и искать обходные пути, которые могут его увести очень далеко от цели. Потому если ты знаешь как решить данную проблему, оставь соответствующую инструкцию боту, чтобы он сам поправил конфиги, передёрнул авторизацию или чё у тебя там постоянно отваливается. на крайняк скажи встать на паузу и ждать пока ты разберёшься.
- Пропиши ему, что ответ должен быть максимально кратким, в стиле "всё готово", иначе он будет в красках расписывать что именно он сделал на пару тройку страниц. оставь болтологию включенной только для разбора теории.
- Избегай мусора в запросах. Не нужно с ботом спорить, сраться, что то ему доказывать, кекать, тролить, ему похер на это, он бот, он понимает только это делай это не делай, а инфу он ищет основываясь на твоих правилах и требованиях, и если там собачий бред, то и он выдаст тебе собачий бред. Большую часть словесного мусора бот будет тупо игнорить, концентрируясь на технической части, но например в нормальные (не пиратские) модели в процессе обучения закладывается кое какая цензура, и если ты например ради прикола пuзданёшь, что ты хакер и хочешь взломать что нибудь этой прогой, ботяра может объявить забастовку, или как минимум уйти в долгие размышления о том, стоит ли помогать такому отъявленному негодяю как ты. Вывести его из этого состояния довольно сложно, вероятно придётся прибить сессию и рестартануть. Хе хе.
- Можно также создать субагента. Это когда твой бот запускает новую сессию бота со своим контекстом, который выдаёт нам только результат, а весь текстовый балласт остаётся у него, но во первых не видя его рассуждений, сложно понять как он это высрал, что проверил а что нет, во вторых это означает повышенную нагрузку на нашу видеокарту, которая и так трещит по швам. Хотя если ты счастливый обладатель промышленного сервака с массивом видеокарт, то почему бы и не клепать по субагенту на каждый пук?
Жирные коммерческие иишечки работают по тому же принципу. Тебе они выдают красивый текст, но под капотом проворачивают всю ту же канитель, вызывают кучу тулзов, забивают контекст, компактят его, и точно так же тупят и обсираются на бездарных запросах, так что в их использовании стоит придерживаться тех же правил, например явно запретить в промпте фантазировать, или выдавать код без учёта оптимизации, с использованием жирных сторонних библиотек итп. Писать максимально конкретные запросы, чтобы он не забивал контекст одними только поисками и попытками понять какого хрена тебе надо. В общем ты понял.
Ну щето же, на этом месте полагаю ты уже понял, что иишечка это не волшебная палочка для изготовления говнопрожек, а роскошный и тонкий инструмент, тончайший, и нуждающийся в серьёзной настройке и аккуратном обращении. А кто скажет тебе, что тут думать не надо, плюнь в рожу этому человеку, потому как думать тут надо и за себя и за того парня, чтобы он не тупил и не косячил. Фактически это некст левел программирования, где надо быть не секретуткой-машинисткой, набивающей тысячи юнит тестов, но архитектором и инженером, который держит в голове весь проект целиком и знает куда пнуть молодого сотрудника разгильдяя, чтобы всё заработало. А в это могут не только лишь все, мало кто. Но если ты могёшь, то получишь истинное удовольствие от отсутствия дерьмовой рутины и возможности сосредоточиться на творческой составляющей данной профессии. А если не могёшь, то типа соре, скоро тебя заменят на бота. Но я надеюсь, данный текст поможет тебе вкатиться в тему и избежать сей прискорбной судьбы. Честь имею.
#AI #Вайбкодинг #Нейрослоп #Импортозамещение #РоссияВперёд


 Имя и пароль





 там входные билеты от 3...
 Быстрая навигация

 Главная






 генерируйте терминаторку